最近在做一个竞对研究。对象是一个硬件 AI 产品站点,跟我们的业务直接竞争。
我先打开它的 sitemap。1,076 个 URL。
然后拉了 Semrush 的 top pages。数据一出来,我盯着屏幕看了一分钟。
1,076 个页面里,月流量过百的只有 39 个。占 3.6%。
这 39 个里,14 个是产品和其他页。剩下 25 个,全是博客。
结论很清晰:这个站 1,076 个页面,真正的流量引擎是博客,而博客里效果明显的只有 25 篇。其他的,都是陪跑。
想必你已经看出来了,今天想讲的是:拿到一个竞对站,该怎么进行研究。
我把它拆成六层。从看得见的,到看不见的。
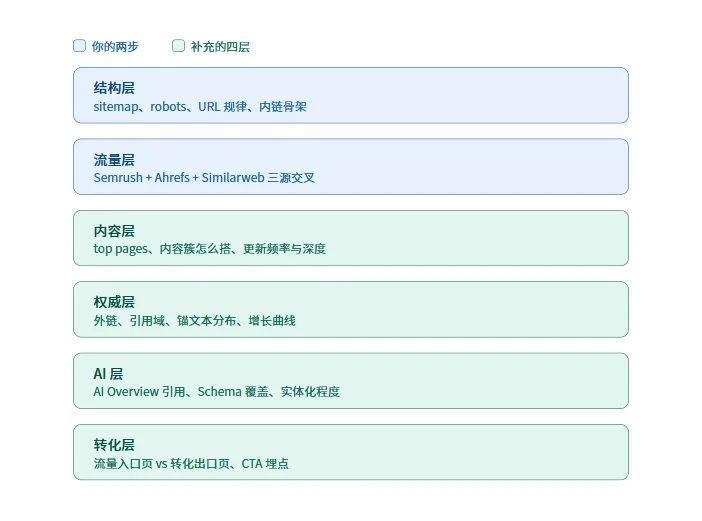
第一层:结构层,从 sitemap 开始
打开 /sitemap.xml 或 /sitemap_index.xml,看三件事。
第一,URL 总量和分布。1,076 个 URL 里,blog 占多少,产品页占多少,tag 和分类页占多少。分布比例直接告诉你它的资源押在哪里。
第二,URL 规律。路径结构暴露信息架构。/blog/、/products/、/templates/ 分得清清楚楚,说明信息架构成熟。搅在一起,说明是长出来的,不是设计出来的。
第三,robots.txt。看它屏蔽了什么。屏蔽的参数页、站内搜索页,就是它踩过的坑,你不用再踩一遍。
然后跑一遍 Screaming Frog。sitemap 是它愿意给你看的,爬虫抓到的是它实际存在的。两个一对比,孤儿页、重定向链、挂着 200 实际跳转的页面,全出来了。
这一层回答一个问题:它的框架是什么,哪些是 SEO 引擎,哪些是凑数的。
第二层:流量层,别只信一个工具
SEMrush 拉自然流量。但有个坑要先说:第三方工具的数据是模型估算的,时效性差,小站点误差能到一半。
保险的做法是三源交叉(但是我懒,我一般就用第一个,也够用了)
SEMrush 看趋势,不看绝对值。12 个月的曲线比单月数字可信且更为直观。这次我看的重点不是它现在月流量多少,而是哪个月开始涨、哪个内容簇在涨。
Ahrefs 再拉一遍。两个工具口径不同,数字能对上六成就算可信。对不上的部分,去查是不是工具抓取范围的问题。
Similarweb 看流量结构。自然搜索占比多少,直接流量多少,社媒多少。一个站如果八成流量靠直接访问,它的 SEO 就不是主战场,你的打法要换。
还有一招校准:拿自己的站当参照。你有自己的 GSC 精准数据,用自己的真实流量除以 Semrush 给你的估算,就得到这个工具在你所在行业的偏差系数。竞对的数字乘以这个系数,比原始数字接近真相得多。
第三层:内容层,top pages 反推内容簇
别看总量,看 top pages。
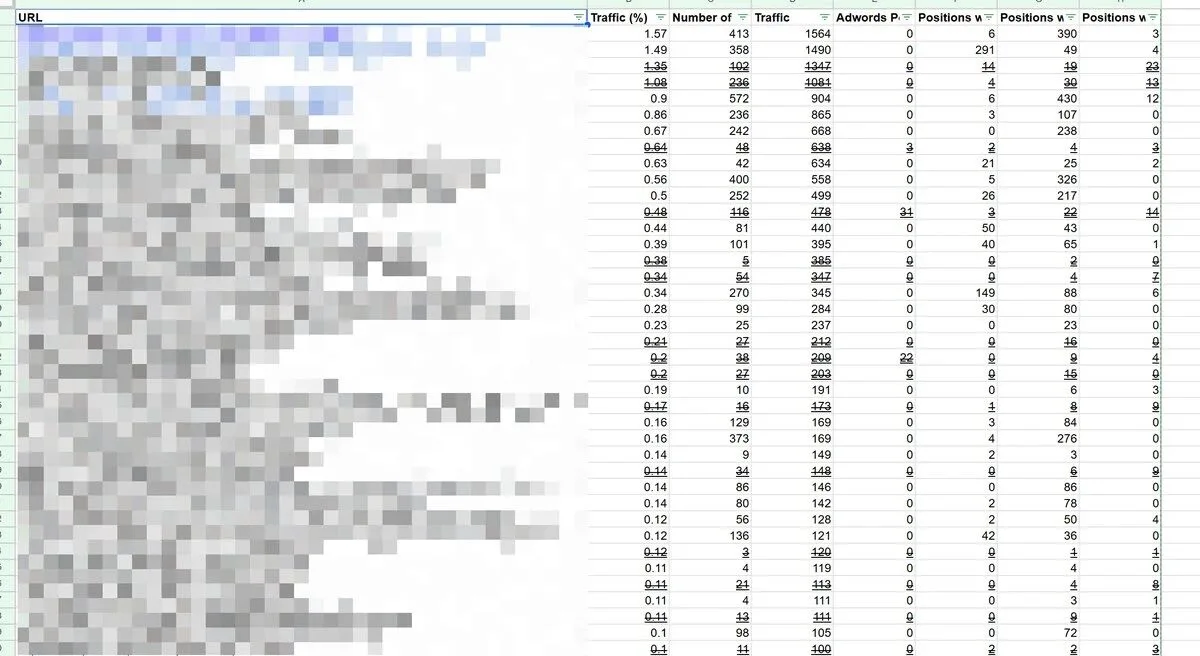
图:竞对站 top pages 数据,流量过百的只有 39 个
这次我看竞对,第一件事就是把流量过百的 39 个页面拉出来,挨个过了一遍。
问三个问题。
第一,这些页面属于哪些话题。把 25 篇高流量博客按主题分组,它的内容簇结构马上现形。哪篇是 hub 页,spoke 页怎么往回连。
第二,内容形态。有没有工具页、模板页、计算器。工具型页面是流量护城河,纯文章很难打得过,这点要提前认。
第三,更新频率。看 sitemap 里的 lastmod,再看页面上的更新时间。多久发一篇新文,旧文多久刷新一次,能看出它的内容团队在多大强度上运转。
这次我看到的是:竞对的高流量页面集中在 3 个话题簇,每个簇一篇 hub 挂 5 到 8 篇 spoke。教科书式的内容簇打法,说明背后有人懂行,不能低估。
第四层:权威层,引用域比外链数重要
打开 SEMrush 或者 Ahref 的 Referring Domains,先看两个数:外链总数、引用域数量。
一万条外链来自 50 个域,不如 500 条外链来自 400 个域。后者才是真的被行业认可。
然后看锚文本分布。品牌词占比过低、目标关键词占比过高,基本就是买过链。买链的站,权重有水分,对战力评估时要打折。
最后挑可复制的外链。行业目录、客座文章、资源页推荐,这些渠道它拿了,你也能拿。我每次都会把可复制的引用域单独整理成一个表。这是整个竞对研究里最直接的行动清单,没有之一。
第五层:AI 层,同行很少查的一层
这层是我做 GEO 以来的固定动作。
拿你们共同竞争的核心 query(也可以直接从 SEMrush 的 AI 可见度板块直接下载),去 ChatGPT、Perplexity、豆包、Kimi 各问一遍,看引用的是谁。
再搜 Google,看 AI Overview 里露出的是谁的内容。
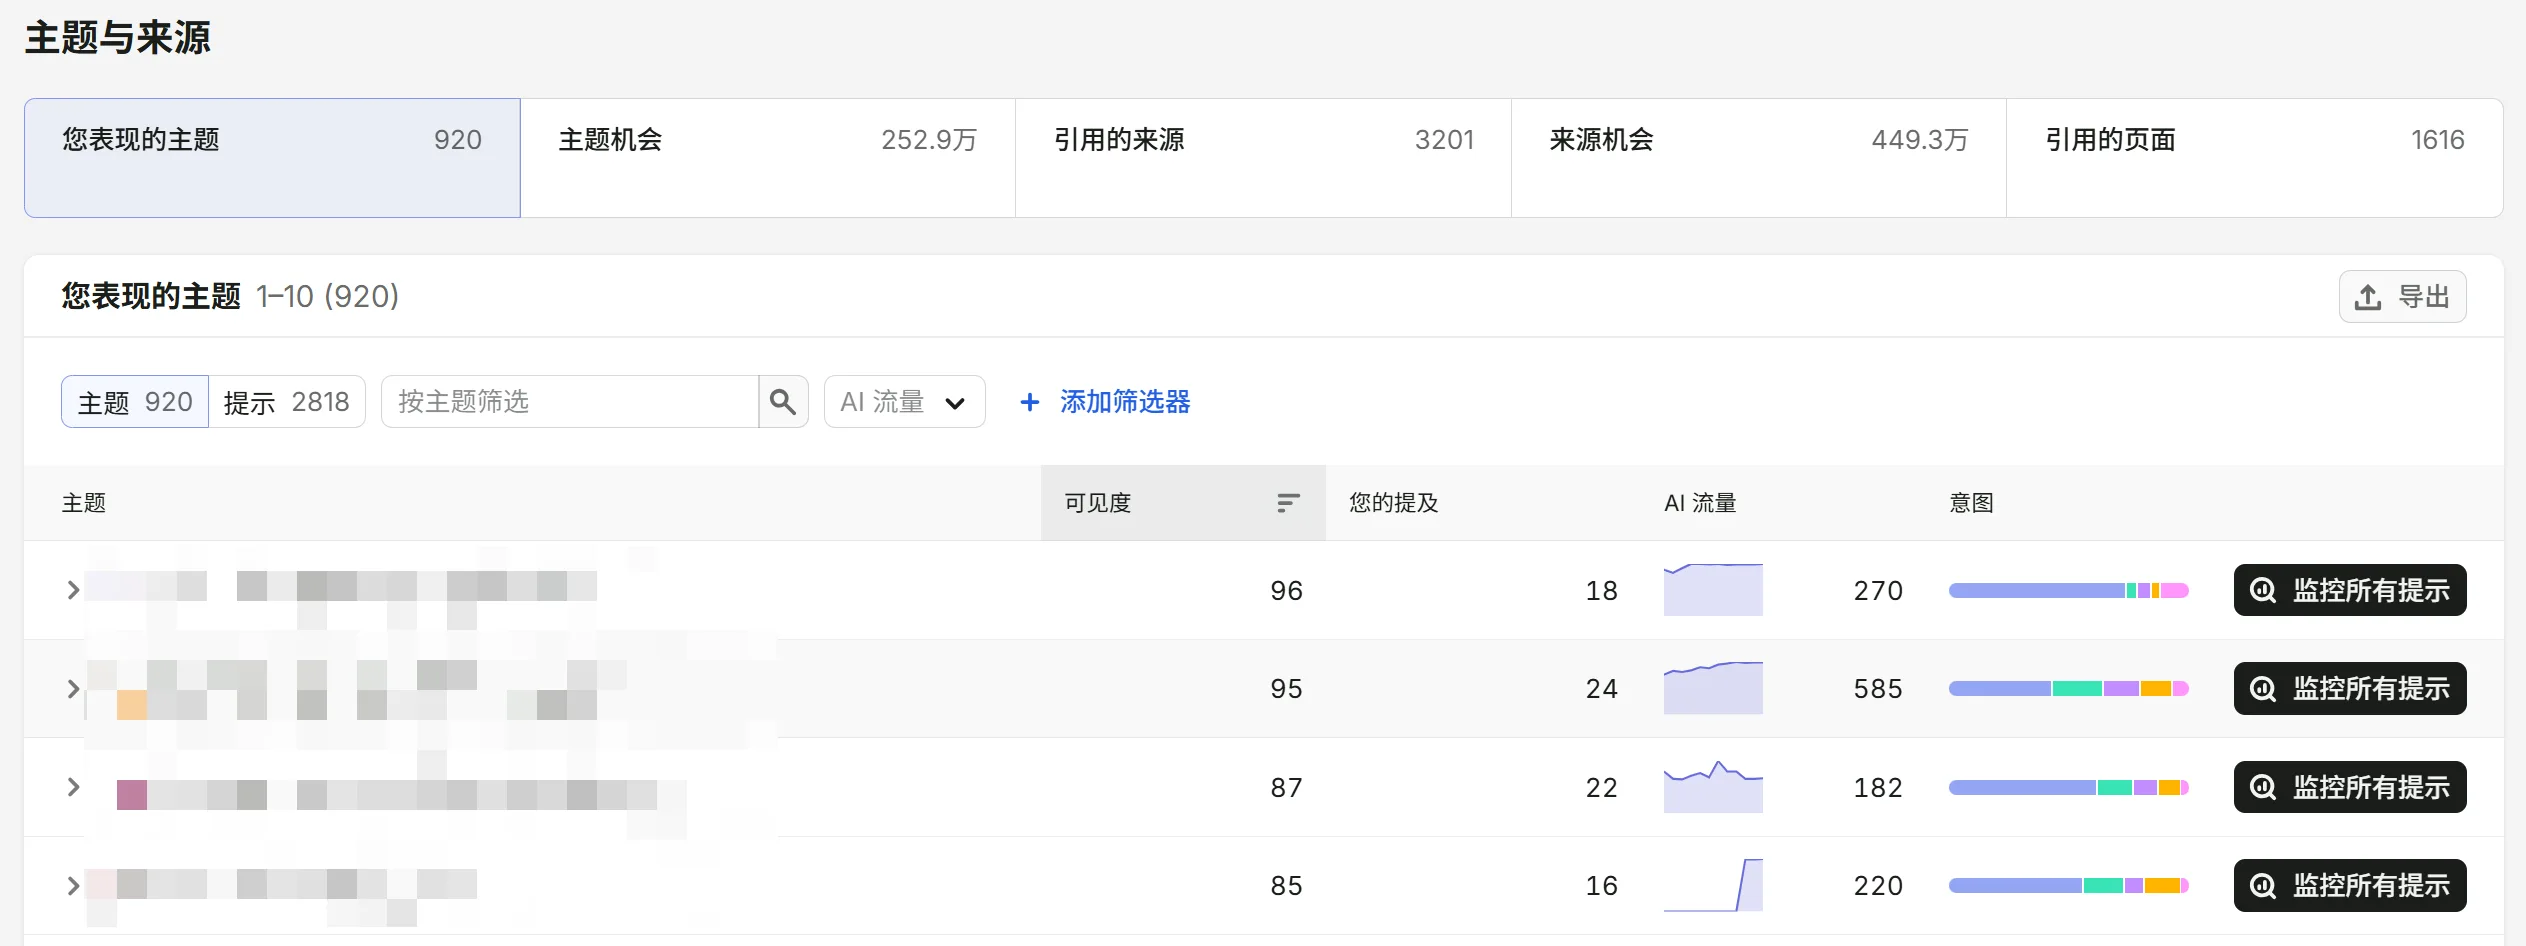
然后打开竞对的高流量页面,看三样东西:有没有 Schema,FAQ、HowTo、Article;小标题是不是问答式;每个段落能不能独立成答案。这三样决定了一件事:AI 搜索爆发的时候,谁的内容会被优先拎出来当答案用。
第六层:转化层,入口页和出口页
最后看商业面。
把它的页面分成两类:流量入口页,博客、产品;转化出口页,产品、定价、注册。
然后看导流设计。博客里的 CTA 长什么样,放在第几屏,指向哪个出口页。工具页用完之后引导去哪。
这决定你该抄什么。有的竞对内容策略强但转化做得糙,那内容打法可以抄,转化自己重新设计。反过来也一样,别把人家弱的部分也学了。
彩蛋:Wayback Machine 看迭代史
多数人研究竞对只看现状。我习惯再挖一层历史。
打开 web.archive.org,输入竞对域名,看两个东西。
第一,重点页面的版本变化。某个 top page 改了几版,每版加了什么板块。改版记录就是它的验证记录,人家已经帮你试过错。
第二,sitemap 的时间线。什么时候新增了某个内容簇,什么时候砍掉了某个栏目。这就是它的策略转折点,比任何一篇行业分析都有用。
研究完了,输出三件事
六层看完,数据一堆。但竞对研究的交付物不是数据,是三个结论。
抄什么。验证过的页面结构、内容簇打法、可复制的外链渠道。
避开什么。它屏蔽的参数、放弃的栏目、买链的痕迹。
从哪切入。keyword gap 里它覆盖薄弱、你又能打的缝隙。这次我找到的缝隙在 AI 层,它没系统做 GEO,我可以先占位。
研究竞对不是研究它有多强,是研究你从哪里下手。
六层 checklist(建议收藏)
1. 结构层:sitemap 加 Screaming Frog,看框架、URL 规律、robots。
2. 流量层:Semrush 加 Ahrefs 加 Similarweb 三源交叉,用自己 GSC 校准偏差。
3. 内容层:top pages 反推内容簇,识别工具型页面和更新频率。
4. 权威层:引用域、锚文本分布、可复制外链清单。
5. AI 层:四大 AI 搜索实测引用,查 Schema 和小标题可抽取性。
6. 转化层:分清入口页和出口页,看 CTA 导流设计。
7. 彩蛋:Wayback Machine 看版本史和策略转折点。
原创文章,作者:流光啸月,如若转载,请注明出处:https://www.lxiaoyue.com/seo/9889/