作为 GEO 从业者,最近两年免不了或主动或被动的需要做 GEO,我也是,毕竟大势所趋。这篇文章,算是自己的一些方法论的总结吧,自己是怎么从 0 开始然后形成相对体系化的做法。
GEO 有个很烦人的点是,做完很难直接看出有没有用。人一旦收不到反馈,就会迷茫,所以体系非常重要。
第 0 步:先说清楚边界
动手之前只有一件事要想明白:你希望内容被哪一类 AI 读到。三类入口,做法不一样。
第一类,AI 搜索的实时检索。 用户问一句,系统临时去网上抓一批页面,读完生成答案,把来源链接挂在下面。ChatGPT、Perplexity、Copilot、AI Overviews、AI Mode 都是这一类。这一类能优化,也是 GEO 这个词真正指的地方。
第二类,训练语料。 内容被抓去训练模型。这一类没法优化,因为它跟用户问什么无关。能做的只有一件事:决定让不让抓。
第三类,产品里的商品推荐位。 用户在对话里问「300 美元降噪耳机推荐」,系统给出商品卡轮播。这一类要的是结构化商品数据,跟内容优化是两条路。
新手常犯的问题是拿第二类的做法去解决第一类的问题,或者反过来。
有一条机制要先记住,后面每一步都建立在它上面:检索型爬虫不执行 JavaScript。
你在浏览器里看到的页面,和它抓到的页面,可能不是同一个东西。内容如果是前端渲染出来的,它看到的就是一个空壳。
自检方法很朴素:打开浏览器的「查看网页源代码」,搜正文里的某一句话。搜得到,说明它在服务端;搜不到,说明它只在 JS 执行之后才存在。
也可以用命令行,抓的是服务器返回的原始 HTML:
curl -sL <你的页面URL> | grep -c "正文里的某句话"返回 0 就是有问题。这条命令查的不只是内容在不在,还是内容在不在正确的位置上。
再或者,如果你在用 Claude Code,可以装 claude-seo 这个开源 skill(GitHub 上是 AgriciDaniel/claude-seo,MIT 协议,目前 1.9 万星左右)。命令行里先跑一句安装:
git clone --depth 1 https://github.com/AgriciDaniel/claude-seo.git && bash claude-seo/install.sh然后在 Claude Code 里执行:
/seo audit https://你的域名需要注意的是,它给的 0 到 100 健康分是自己的分诊启发式;全站审计消耗的额度不小,可以先拿 /seo page 跑单页试试;页面内容会发给模型,有合规要求的站先看清楚再跑。
第 1 步:装四个读数
这一步不产生流量,但是是我们衡量效果的主要来源。
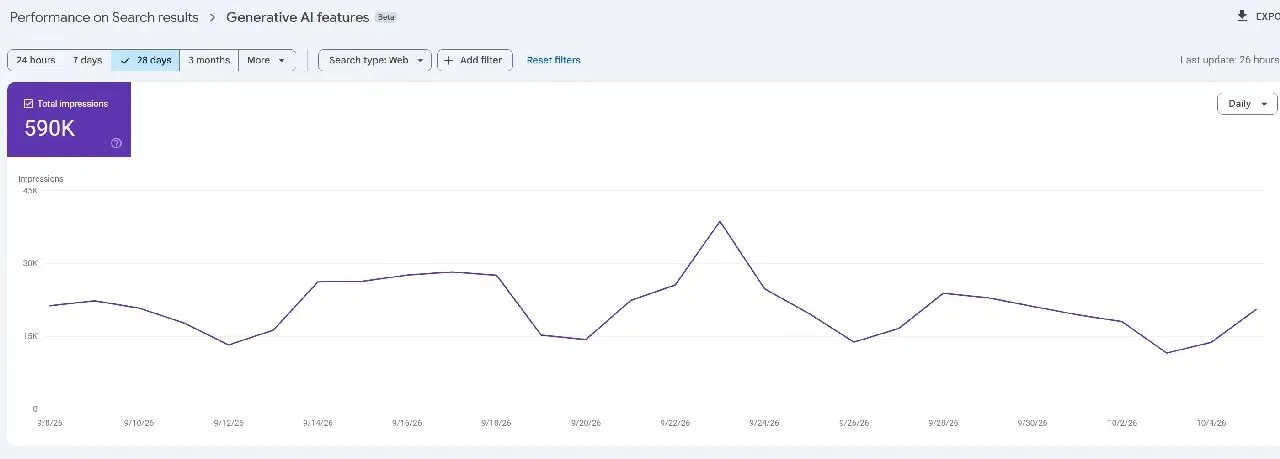
读数一:Google Search Console 的生成式 AI 报告
2026 年 6 月 3 日上线,数据从 5 月 18 日开始,8 月 31 日推到全球所有站点。
它只有一个指标,曝光。维度四个:页面、国家、设备、日期。
它没有的东西比它有的更重要,得记清楚:
- 没有点击。点击是算的,但混在普通网页搜索里,没有任何过滤能单独捞出来
- 没有查询词维度,你没法知道是哪个问题带来了这次曝光
- 不区分 AI Overviews 和 AI Mode,两者合并报
- 没有历史回填,你哪天能看到,基线就从哪天开始
- 图表合计和表格合计会对不上,一个按站点聚合、一个按页面聚合
- 列表 1,000 行上限
还有一条容易被误用:这份报告的曝光已经包含在网页搜索总曝光里,是它的子集。所以「AI 曝光 ÷ 总曝光」算出来的不是份额,是一个东西比它自己,这个比值没有意义,别放进周报。
它能回答的问题其实只有一个:哪些页面在被 AI 挂出来。这一条够用了。按页面排序,靠前的就是你的资产。
读数二:Bing Webmaster Tools 的 AI Performance
2026 年 2 月 10 日公测,6 月 16 日加了四项。免费,覆盖 Copilot、Bing 的 AI 摘要和部分合作方。
四个基础指标:总引用次数、日均被引用页面数、grounding query、页面级引用数。
grounding query 是这份报告里最值得看的东西。 它是 AI 自己写给自己的检索词,不是用户打的那句话。用户问「哪个降噪耳机好」,AI 实际去搜的可能是「降噪耳机 通勤 300 美元 对比」。这类词在任何关键词工具里都找不到,因为没有人会这么打字。
6 月加的四项里,Citation Share 是唯一适合长期盯的,定义是某个 grounding query 下,你的引用数占所有站点引用数的百分比。
它比绝对引用数好用。绝对数会随查询量漂移,涨了不代表你变强,可能只是问的人多了。份额受这个影响小一些。
Bing 自己说得很清楚,这是观测指标,不是排名系统,不暴露竞对域名,也不代表流量份额。覆盖范围也有限,ChatGPT、Perplexity、Google 的 AI 功能都不在里面。
读数三:服务器日志里的 AI 爬虫
最容易做,也最少人做。去日志里看有没有这些爬虫来过、多久来一次、抓了哪些页面。关键是要分开看,两类爬虫用途完全不同:
- 检索型:OAI-SearchBot、PerplexityBot,它们来了说明你有机会被引用
- 训练型:GPTBot、ClaudeBot、CCBot,它们来了跟你能不能被引用无关
一个常见的事故是,为了让内容不进训练语料,把检索型爬虫一起挡了。结果是被引用率归零,而训练那边其实没受影响,因为 Google-Extended 这类指令只管训练,不影响 AI Overviews 的可见性。
读数四:自建固定 prompt 样本
前三个读数都有覆盖不到的地方,所以要自己补一个。
做法很土:挑 30 个你真正关心的问题,每周固定时间、固定入口问一遍,记三件事。
- AI 有没有给出带来源的答案
- 来源里有没有你
- 如果有,它引用的是不是你想让它引用的那一页
这件事没有工具能替你做,因为工具跑的是它自己的 prompt 集,不是你的。但重复劳动那部分可以交给脚本。
前提是你得有对应 AI 的 API credentials。 有 OpenAI 的 key 就跑 OpenAI,有 Perplexity 的就跑 Perplexity,思路都一样:把 30 个问题存成一个 JSON,脚本挨个问,从回答里把引用链接抠出来,数里面有几个是你的域名,结果按日期存一份。
下面是一个最小可用版,用 OpenAI 的 Responses API,打开联网检索开关:
import json, os, time, urllib.request
API_KEY = os.environ["OPENAI_API_KEY"]
MODEL = os.environ.get("GEO_MODEL", "填你账号里可用的模型名")
SITE = "example.com"
PROMPTS_FILE = "prompts.json"
def ask(q):
    req = urllib.request.Request(
        "https://api.openai.com/v1/responses",
        data=json.dumps({
            "model": MODEL,
            "input": q,
            "tools": [{"type": "web_search_preview"}],
        }).encode(),
        headers={
            "Authorization": "Bearer " + API_KEY,
            "Content-Type": "application/json",
        },
    )
    with urllib.request.urlopen(req, timeout=90) as r:
        return json.load(r)
def cited(resp):
    """抽出这次回答里所有被引用的 URL。接口改版时只需要改这一个函数。"""
    urls = set()
    for item in resp.get("output", []):
        for block in item.get("content", []) or []:
            for a in block.get("annotations", []) or []:
                if a.get("type") == "url_citation" and a.get("url"):
                    urls.add(a["url"])
    return urls
rows = []
for q in json.load(open(PROMPTS_FILE, encoding="utf-8")):
    resp = ask(q)
    all_urls = cited(resp)
    mine = [u for u in all_urls if SITE in u]
    rows.append({
        "question": q,
        "cited_total": len(all_urls),
        "cited_mine": len(mine),
        "urls": mine,
    })
    time.sleep(2)
out = "sample_%s.json" % time.strftime("%Y%m%d")
json.dump(rows, open(out, "w", encoding="utf-8"), ensure_ascii=False, indent=2)
hit = sum(1 for r in rows if r["cited_mine"])
print("命中 %d / %d,明细见 %s" % (hit, len(rows), out))
三个使用要点:
- 结果文件按日期命名,扔进 git 仓库,每周固定跑一次,diff 就是趋势线
cited()单独抽出来,接口改版只改这一个函数,其余不动- 成本按次算,30 个问题一次几块钱以内,比人工半小时便宜,也比人工稳
四个读数合起来,是四层可见性,从上往下越来越难:AI 模块出现 → 你的内容被引用 → 有人点进来 → 有人下单或询盘。
第二篇那个案例就是典型:曝光从 118,193 涨到 251,282,多了 133,089,涨了 112.6%,点击从 0 变成 1。第一层涨了一倍多,第四层几乎没动。只看第一层的人会以为自己在赢。
真正的难点:成交不在 AI 里发生
四个读数能覆盖到第三层,第四层基本测不到,这是 GEO 衡量里最难的部分,得单独讲。
原因是用户的行为被切成了两段。前一段在 AI 里:问、比、筛,看答案里挂了谁。后一段不在 AI 里:回到 Google 搜品牌名,或者直接输域名进站,或者发邮件和线下谈。目前大部分人还只是拿 AI 做搜索和调研,真正下单那一脚仍发生在传统搜索里。
中间这一段没有标记位。AI 给的链接你改不了,加不了 UTM;从对话跳到你站上的访问,在统计里多半落到直接访问或自然搜索里;再加上手机问、电脑买,跨设备又断一层。
我这边后端能直接归到 AI 助手的订单,数量很少,少到没法拿来做判断。这不是统计工具没配好,是这条链路上本来就没有一个能被稳定识别的来源标记。
所以别把 GEO 当一个能算最后点击 ROI 的渠道用,它是影响上游的动作。真要判断,只能换几个间接的读法:
- 看品牌词和直接访问的位移。引用份额上去之后,过 4 到 8 周看品牌词搜索量和直接访问有没有跟着动。单独看没意义,要跟引用份额放在一起看
- 在询盘或下单流程里加一个自填项。问一句「你是怎么知道我们的」,选项里放上「AI 助手(ChatGPT 这类)」。自填不准,但这是唯一能直接问到的方式,攒几个月能看出方向
- 查一下日志里有没有 chatgpt.com 这类来源。少数情况下 referrer 会带出来,可以看看量级,但别指望它稳定,更别当主指标
能稳定衡量的是前三层。第四层只能靠间接信号拼。接受这一点,比硬凑一个 ROI 数字要诚实,也省得在会上被一个问题问倒。
第 2 步:选战场,别全站改
衡量装好之后,才是选改哪里。
不要全站改。 新手第二个常犯的错,是拿到一份 GEO 优化清单就逐页套。100 个页面改完三个月,数据没变化,因为你改的 100 个页面里,可能只有 3 个有机会被引用。
选战场的标准只有一条:这个页面在 Google 里已经有基础。
做法是打开 GSC 的查询报表,筛排名在 5 到 20 位、有曝光但点击偏低的词。这批词方向被验证过,AI 检索时大概率会翻到;同时还没到顶,改一改有空间。
排名 50 开外的先放着。不是它们不重要,是在它们身上做的每次改动都收不到反馈,没法迭代。
第二个筛选条件常被忽略:这个问题 AI 会不会真的去检索。
会去检索的:有时效性的(今年最好的 X)、需要对比的(A 和 B 的区别)、带具体参数的(300 美元以内的 X)、涉及评测实测的。
不会去检索的:纯品牌导航(某某官网登录)、简单事实、模型自己就知道的常识。
如果你卖的东西全在第二类,GEO 对你基本无效。这句话很少有人讲,但它能帮你省下三个月。
用 Bing 的话,10 月 13 日上线的 Topics Portfolio 可以直接用。它把站点的 grounding query 聚成主题,每个主题下列出机会 query,也就是别人被引用了、你没有的那些。官方明说这些数字是方向和区间,不是精确账本,拿来排序可以,做流量预测不行。
第 3 步:改的四条,每条都有个理由
选好 5 到 10 个页面,才开始改。
第一,让段落能被整句摘走。
AI 引用的时候摘的是能独立成立的一段话。那种靠上下文才读得懂的段落,它摘不走。
判断方法:把某一页的任一小节复制到空白文档,去掉前后文,看它还成不成立。不成立就重写。
这条在 2026 年 10 月之后更急了。有测试显示 Google 在试着把 AI Overview 右侧那列引用卡片整个拿掉,只留答案正文里的内联链接。如果这个改动铺开,正文内联链接就从其中一个出口变成唯一出口。
第二,把实体说清楚。
你写的是哪个品牌、哪个产品、哪个人,要让机器能确定。第十篇里查过一堆实验,结论是结构化数据里唯一稳定正相关的是实体消歧,也就是 Organization 加上 sameAs 指向 Wikidata、LinkedIn、Crunchbase 这类能被第三方核对的身份源。
这条换个地方也成立:一个东西的权重,等于它能被第三方验证的程度。自己说自己是谁没用,有独立信源能核对才有用。
第三,别堆 schema。
这条跟市面上大部分 GEO 入门文相反,但数据在这:有对照组的实验里,1,885 个加了 JSON-LD 的页面对比 4,000 个控制页,AI Overviews 的引用率下降 4.6%。另一项研究发现,半填充的 schema 比完全没有 schema 差 18 个百分点。
插件自动生成的残缺标记是重灾区。宁可删,不要留。
第四,别把 llms.txt 当主业。
84.4 万个站点写了 llms.txt,没有一家主要 AI 厂商承认会读它。很多人不信这个数字,我一开始也不信。
判断这类新东西值不值得做,用三问:谁承诺读了?读了之后改什么行为?不做的代价是什么?三问答不上来,多半只是供给端热闹,跟你没关系。
第 4 步:三个控制别搞混
这一步不是优化,是防事故。新手容易在这里做错,而且做错会伤到自然流量。
- Google-Extended:放在 robots.txt 里,只挡用于训练模型的抓取,不影响你在 AI Overviews 里的可见性
- nosnippet / data-nosnippet:不让搜索引擎抽取正文生成摘要。它能挡 AI Overviews,代价是普通自然结果的摘要也没了,点击率一起掉
- Search Console 里的 AI 开关:只退出 AI Overviews、AI Mode 和 Discover 的 AI 功能,不影响自然排名。这是三个里唯一干净的那个,不适用于独立的 Gemini 应用
默认建议是三个都不动,先把基线攒起来再说。
30 天怎么排
| 时间 | 做什么 | 产出 |
|---|---|---|
| 第 1 周 | 装四个读数,跑第一次 | 一份基线数字 |
| 第 2 周 | 用 curl 或看源码确认核心页服务端有内容 | 一份问题页面清单 |
| 第 3 周 | 筛出 5 到 10 个有基础的页面 | 一份战场清单 |
| 第 4 周 | 改 5 个页面,只改能被摘走的段落和实体 | 第一版改动 |
| 第 5 周起 | 每周跑一遍固定 prompt 样本,脚本或手跑都行 | 第一条趋势线 |
第 1 周不能省。跳过它,后面四周做的每件事都没法验证。
四周之后你手上应该有的,不是「我做了 GEO」,而是三张表:哪些页面在被引用、哪些问题你在输、这周比上周是变好还是变差。
最后三条自检
能不能说出一个你输了的问题。 只知道赢的,说明你在挑数据看。
能不能说出一个你改了但没用的页面。 一个都没有才可疑,要么改得太少,要么根本没在衡量。
工具明天改版,你还知道该怎么办吗。 某个报表一变你就不会算了,说明你记的是操作步骤,不是方法。